Transformez les fichiers Parquet et Delta en API HTTP rapides et interrogeables
Découvrez un serveur piloté par la configuration qui expose des fichiers Parquet, Delta et Iceberg en tant qu'APIs HTTP typées avec des sorties Arrow ou JSON. DataPress, du développeur DataPress, cible les ingénieurs de données et les développeurs d'applications qui ont besoin d'un accès à faible latence aux ensembles de données en colonnes. Il offre des moteurs d'exécution doubles (DuckDB et DataFusion), un rechargement à chaud des ensembles de données en mémoire et des métriques intégrées, ce qui le rend adapté aux déploiements conteneurisés et au contrôle programmatique depuis Python ou le CLI.
Que publie réellement DataPress et comment ?
DataPress publie des données en colonnes sous forme de points de terminaison HTTP. Il convertit les ensembles de données Parquet, Delta et Iceberg en API typées qui renvoient JSON ou Arrow IPC. Le serveur infère le schéma au démarrage, donc vous ne mappez pas les colonnes manuellement, et il expose un point de terminaison SQL brut optionnel qui valide et exécute des jointures, des fonctions de fenêtre et des sous-sélections contre les fichiers sous-jacents.
Comment cela affecte-t-il les performances du système lors des requêtes ?
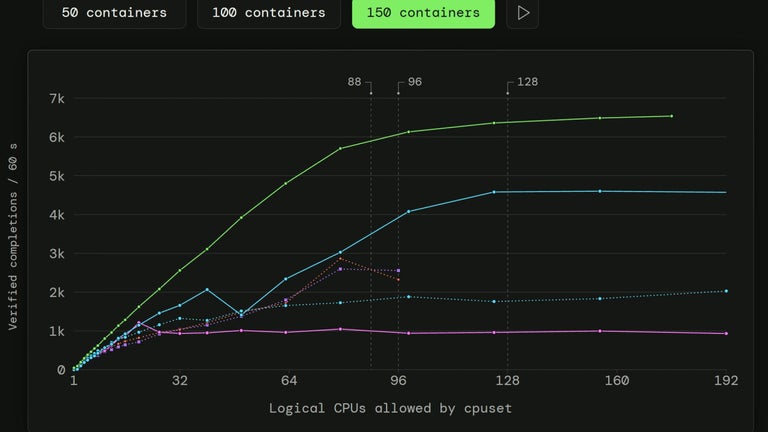
Les performances se concentrent sur la mémoire en colonnes et les chemins sans copie. Construit en Rust, l'outil utilise Arrow IPC pour éviter la surcharge de sérialisation JSON pour les grands transferts et s'appuie sur des formats en colonnes pour réduire la pression mémoire. Vous pouvez basculer entre DuckDB et DataFusion pour comparer la latence sous des contrats API identiques, et le rechargement à chaud met à jour les ensembles de données en mémoire sans redémarrer le serveur.
Est-il sûr de le déployer dans un environnement de production ?
Les fonctionnalités de production incluent l'observabilité et le contrôle d'accès. Le serveur expose des métriques et des points de terminaison de vérification de l'état pour le monitoring et prend en charge OAuth2 et OIDC pour l'accès aux ensembles de données. Il fournit également des sondes de vivacité et de disponibilité Kubernetes et un support natif de stockage d'objets S3, qui correspondent aux modèles de déploiement conteneurisés et aux magasins d'objets cloud courants.
Ai-je besoin de compétences approfondies en Rust ou SQL pour l'utiliser ?
La complexité opérationnelle penche vers la configuration et la familiarité avec SQL. Vous gérez le service via une CLI autonome ou un wheel Python pour un contrôle programmatique, et le serveur utilise un seul fichier de configuration pour publier des ensembles de données. Les utilisateurs occasionnels devront apprendre le schéma de configuration ; les équipes d'analyse et les ingénieurs obtiennent un contrôle direct grâce au point de terminaison SQL brut optionnel et au choix du moteur de backend.
Bon choix pour les ingénieurs qui ont besoin d'APIs de données rapides et à faible surcharge
DataPress convient aux ingénieurs de données et aux développeurs qui publient rapidement des ensembles de données en colonnes sur HTTP et qui ont besoin de surveillance de production et d'authentification. Attendez-vous à investir du temps dans la configuration et la comparaison des backends lors de l'ajustement pour des charges de travail spécifiques. Le compromis est que le contrôle opérationnel dépend de la configuration et des compétences en SQL plutôt que d'une interface de gestion graphique, donc c'est mieux pour les équipes à l'aise avec le code et l'infrastructure.